목차
- 왜 메시지가 실패하는가
- Retry 전략
- DLT 설계
- 모니터링과 운영
- 참고
왜 메시지가 실패하는가
메시지 처리 실패는 두 범주로 나뉜다. 이 구분에 따라 재시도 전략이 달라진다.
일시적 실패
일시적으로 발생하지만 시간이 지나면 자연 해결되는 실패
- 네트워크 타임아웃 (downstream 서비스 일시 불통)
- 데이터베이스 커넥션 풀 고갈
- Rate limiting (429 응답)
- 일시적인 리소스 부족 (디스크, 메모리)
특징: 동일한 메시지를 나중에 다시 처리하면 성공할 가능성이 높다.
영구적 실패
몇 번을 재시도해도 절대 성공하지 않는 실패:
- 메시지 포맷 오류 (역직렬화 불가)
- 비즈니스 로직 위반 (존재하지 않는 유저 ID 참조)
- 스키마 불일치 (producer가 새 스키마로 보냈는데 consumer가 구 스키마)
- 프로그래밍 버그 (NullPointerException 등)
특징: 재시도는 무의미하다. 오히려 재시도가 시스템 리소스를 낭비하고 후속 메시지의 처리를 지연시킨다.
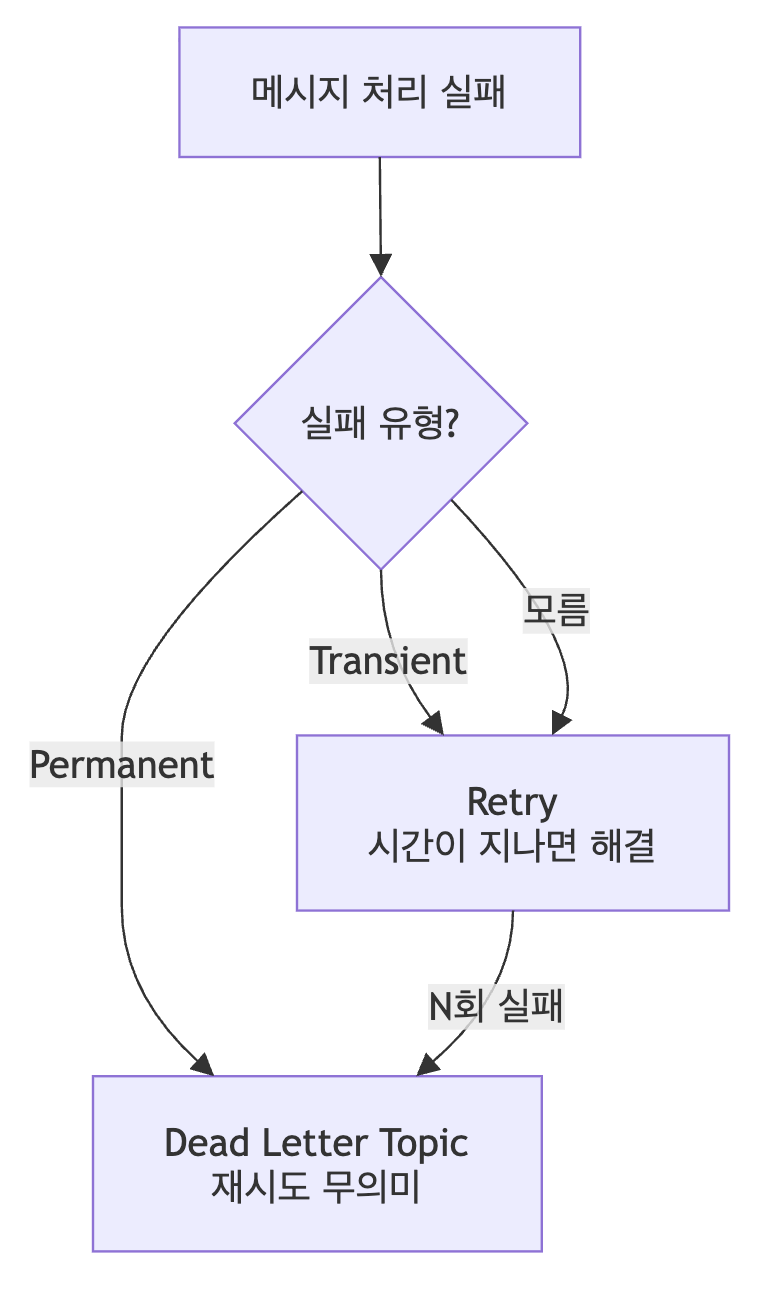
이 분류가 에러 관리의 출발점이다. Transient failure에는 재시도를, permanent failure에는 즉시 격리를 적용해야 한다.
문제는 실패 시점에 이 둘을 완벽히 구분하기가 쉽지 않다는 것이다 — 그래서 "N회 재시도 후 실패하면 DLT로" 라는 전략이 현실적인 타협점이 된다.
Retry 전략
고정 백오프 (Fixed Backoff)
가장 단순한 재시도 전략이다. 실패 후 고정 시간 대기 후 재시도하면 된다:
attempt 1 → 실패 → 5초 대기
attempt 2 → 실패 → 5초 대기
attempt 3 → 실패 → 5초 대기
attempt 4 → DLT로 이동문제: downstream이 과부하 상태일 때, 모든 consumer가 동시에 5초 후 재시도하면 다시 과부하를 유발한다 (thundering herd).
지수 백오프 (Exponential Backoff)
대기 시간을 지수적으로 증가시키면 된다:
attempt 1 → 실패 → 1초 대기
attempt 2 → 실패 → 2초 대기
attempt 3 → 실패 → 4초 대기
attempt 4 → 실패 → 8초 대기
attempt 5 → DLT로 이동Jitter를 추가하면 thundering herd를 방지할 수 있다:
delay = min(base * 2^attempt + random_jitter, max_delay)
Retry Topic 체인
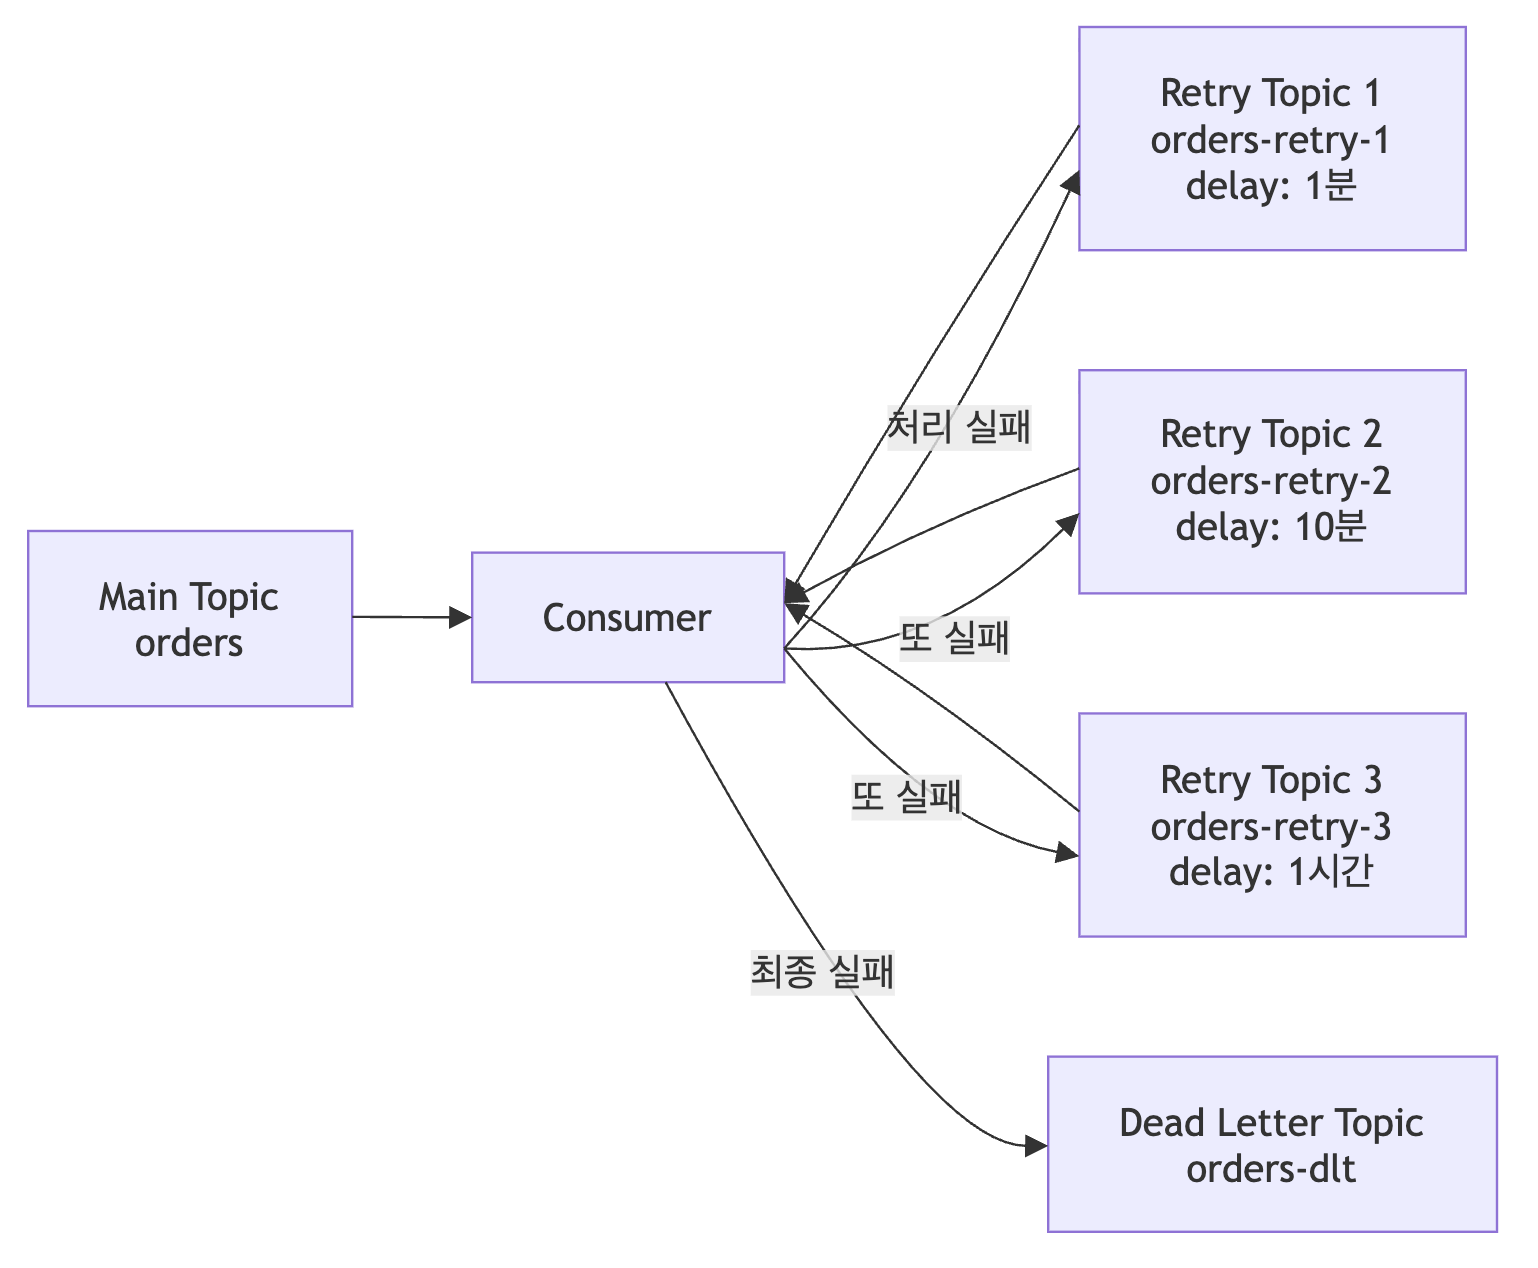
Kafka에서 재시도를 구현하는 가장 일반적인 패턴이다. 메인 토픽에서 실패한 메시지를 별도의 retry 토픽으로 보내고, 지연 후 다시 처리한다
구조:
orders→ 메인 처리orders-retry-1→ 1분 후 재시도 (1차 실패)orders-retry-2→ 10분 후 재시도 (2차 실패)orders-retry-3→ 1시간 후 재시도 (3차 실패)orders-dlt→ 최종 실패. 사람이 개입해야 한다.
지연 구현: Kafka 자체는 delayed delivery를 지원하지 않으므로:
- Consumer가 메시지의 timestamp를 확인하고, 아직 delay 시간이 안 됐으면 처리하지 않고 잠시 pause
- 또는 별도의 delay service가 일정 시간 후 다음 토픽으로 produce
장점:
- 메인 토픽의 처리가 block되지 않음
- 재시도 간격을 단계별로 다르게 설정 가능
- 각 단계의 메시지 수를 모니터링하여 시스템 건강 상태를 파악할 만하다
DLT 설계
메시지 구조
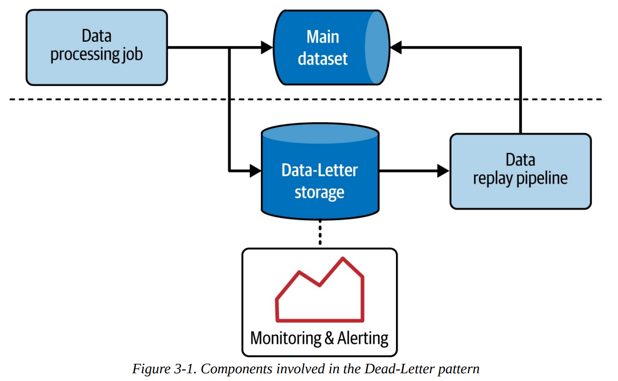
DLT에 저장되는 메시지는 원본 메시지 + 실패 컨텍스트를 모두 포함해야 한다:
{
  "original_topic": "orders",
  "original_partition": 3,
  "original_offset": 1847293,
  "original_timestamp": "2026-08-14T09:23:17.442Z",
  "original_key": "order-12345",
  "original_value": "<원본 메시지 바이트>",
  "original_headers": { "correlation-id": "abc-123" },
  "failure_timestamp": "2026-08-14T09:25:31.102Z",
  "failure_reason": "com.fasterxml.jackson.core.JsonParseException: Unexpected character",
  "failure_stacktrace": "...(truncated)...",
  "retry_count": 3,
  "consumer_group": "order-processor",
  "consumer_instance": "pod-order-processor-2"
}
필수 필드:
- 원본 메시지 전체 (복구/재처리에 필요)
- 실패 원인 (분류 및 디버깅에 필요)
- 재시도 횟수 (어느 단계에서 실패했는지)
- 타임스탬프 (원본 발생 시각 + 실패 시각)
바이너리 메시지(Avro, Protobuf 등)는 DLT 저장 시 base64 인코딩할지, 원본 바이트를 그대로 넣을지 선택이 필요하다. 원본 바이트를 그대로 넣으면 스키마 레지스트리 없이 역직렬화할 수 있어 운영이 편하다. JSON 기반이면 그대로 문자열로 넣으면 된다.
소비자 전략
DLT에 쌓인 메시지를 어떻게 처리할 것인가를 살펴보면:

전략 1: 자동 Replay
- 버그를 수정한 후, DLT의 메시지를 원본 토픽으로 재발행
- 주의: idempotency (멱등성)가 보장되어야 한다. 아니면 중복 처리 위험.
전략 2: 운영자 대시보드
- 각 DLT 메시지를 UI에서 확인
- 건별로 "재처리", "무시", "수동 보정" 결정
- 소량의 permanent failure에 적합
전략 3: 자동 분류 + 선별 수동 처리
- Error code로 transient/permanent를 자동 분류
- Transient → 자동 재처리 (일정 시간 후)
- Permanent → 운영자에게 알림
DLT에서의 순서 보장 문제
DLT에서 replay할 때 원래 토픽의 순서를 복원해야 하는 경우(주문→결제 같은 인과관계)가 있다. 단순 replay로는 해결되지 않으며, 두 가지 접근이 있다:
- DLT 메시지에 원본 offset/partition 정보를 담아 순서대로 정렬 후 replay
- 인과관계가 있는 메시지는 같은 partition key를 쓰도록 강제하여 순서를 보장
Snowball Effect
DLT 설계에서 가장 위험한 시나리오는 눈덩이 효과다:
- 서비스 장시간 장애 -> 모든 메시지 실패
- Retry topic에 메시지 폭증
- Retry consumer 리소스 포화
- DLT에 대량 유입 (수만~수십밤ㄴ 건)
- DLT 소비자 처리불가
- 디스크 포화
원인: Downstream 서비스가 장시간 다운되면, 모든 메시지가 retry chain을 따라 이동하다가 결국 DLT에 대량으로 쌓인다.
이건 개별 메시지의 "영구 실패"가 아니라 인프라 차원의 일시적 장애인데, 시스템은 이를 구분하지 못한다.
완화 전략:
- Circuit Breaker: downstream 실패율이 임계치를 넘으면 retry 자체를 중단하면 된다. 장애 복구 후 일괄 재처리.
- DLT 용량 알림: DLT 유입률이 급증하면 즉시 알림 (이건 개별 메시지 문제가 아니라 시스템 장애 신호)
- Retry budget: 시간 단위로 retry 횟수에 상한을 두면 된다. 초과하면 잠시 중단.
- Backpressure: retry topic의 consumer lag이 임계치를 넘으면 메인 consumer의 처리 속도를 줄인다
모니터링과 운영
핵심 메트릭
| 메트릭 | 의미 | 알림 조건 |
| DLT 유입률 (msg/s) | 단위 시간당 DLT 신규 메시지 | 급증 시 (평소 대비 10x) |
| DLT 총 적재량 | 미처리 DLT 메시지 수 | 임계치 초과 시 |
| Retry topic consumer lag | 재시도 대기 중인 메시지 수 | 지속 증가 시 |
| 에러 유형별 분포 | transient vs permanent 비율 | permanent 비율 급증 시 |
| 평균 재시도 횟수 | 성공까지 필요한 평균 시도 | 증가 추세 시 |
운영 대시보드 구성
- 실시간 모니터링
- DLT 유입률 시계열 차트
- 에러 유형 분포 파이 파이 차트
- Retry 단계별 적재량
- 운영 도구
- 개별 메시지 상세 조회
- 일괄 재처리 트리거
- DLT 메시지 수동 보정
운영 체크리스트
- DLT retention 설정: DLT 메시지를 영구 보관할 것인가? 보통 7~30일 retention 후 장기 저장소(S3 등)로 아카이빙하면 된다.
- 알림 에스컬레이션: DLT 유입률 급증 → 온콜 알림 → 15분 내 미대응 시 매니저 에스컬레이션.
- 정기 리뷰: 주 1회 DLT 메시지를 리뷰하여, permanent failure의 근본 원인(스키마 불일치, 버그 등)을 수정해야 한다.
- 재처리 파이프라인: 버그 수정 후 DLT 메시지를 자동으로 원본 토픽에 재발행하는 도구를 사전에 구축해두면 된다.
- Idempotency 보장: 재처리 시 중복 효과가 없도록 consumer의 idempotent 처리가 전제되어야 한다.
아키텍처

결론
- Transient vs Permanent 구분: 재시도할 가치가 있는 실패와 없는 실패를 분류한다.
- 단계적 격리: Retry topic chain으로 메인 처리를 block하지 않으면서 재시도한다.
- Snowball 방지: Circuit breaker와 backpressure로 cascade failure를 막는다.
- 운영 루프: DLT는 끝이 아니라 시작이다. 재처리 도구와 정기 리뷰가 있어야 한다.
참고
- Konieczny, B. (2024). Data Engineering Design Patterns. Manning. Chapter 3: Error Management Design Patterns — Dead Letter Queue.
- Shapira, G., Palino, T., Sivaram, R., & Petty, K. (2021). Kafka: The Definitive Guide 2nd Ed. O'Reilly. Chapter 7: Building Data Pipelines.
'Engineering' 카테고리의 다른 글
| 내가 헥사고날 아키텍처에 회의적인 이유 (0) | 2026.09.04 |
|---|---|
| 카프카가 빠른 이유 (0) | 2026.08.15 |
| K8s + Spring Boot: Graceful Shutdown 제대로 이해하기 (0) | 2026.08.12 |
| [HTTP] POST, PUT, PATCH 그리고 멱등성 (1) | 2024.01.02 |


댓글